
Harness对CDE构建的启示
CDE 与大语言模型如何更紧密地协作?Harness 对资料供给、功能调用、执行反馈和运行约束的组织,为增强信息检索、整理、检查与成果溯源提供了启发。
- 作者:
- 一吨先生
当通用数据环境(CDE)开始借助人工智能(Artificial Intelligence,AI)查找资料、整理信息时,几个问题随之出现:
- 检索充分吗? 返回了相关资料,是否还有更适合当前用途的信息没有找到?
- 规则贯彻了吗? 整理一批资料时,事先约定的分类、命名和版本处理规则,是否得到持续执行?
- 成果检查了吗? AI 宣布“完成”时,资料遗漏、重复归类和字段缺失等问题,是否已经核对?
这些疑问指向 AI-based CDE(将 AI 融入自身信息管理能力的 CDE)的一个核心问题:大语言模型(Large Language Model,LLM)具备理解和推理能力,同时还具有不确定性,怎样才能与 CDE 的信息、规则和其他功能更紧密地协作?人工智能领域的 harness,为思考这种结合提供了启发。
CDE 的能力,还可以怎样增强
CDE 是 Common Data Environment 的缩写,中文为“通用数据环境”(也可称为“共用数据环境”)。它是项目各方按照约定流程收集、管理和分发信息的环境,可以由多个软件系统共同支撑。
CDE 管理图纸、建筑信息模型、技术文档等电子文件和数据。CDE 通过规则和工作流管理这些信息,并可借助软件实现部分自动化处理,以支持信息的完整性、准确性、共享和追溯。其中,工作流(workflow)规定工作经过哪些环节,例如编制、检查、批准和发布;版本用于区分资料的不同修订;状态及相关记录则说明资料处于什么阶段、获准用于什么工作。常见状态包括:
- 工作中(Work in Progress,WIP):资料仍在编制,由相应任务团队处理。
- 已共享(Shared):资料可供有关参与方按约定用途使用,例如专业间协调。
- 已发布(Published):资料已获得相应授权,可用于指定工作。
- 归档(Archive):保留资料流转和变更的历史,以便查证。[1]
在现有 CDE 的使用中,理解具体问题、选择信息、解释差异,以及组织下一步处理,往往仍较多依赖操作人员。例如,面对“整理这一阶段可供移交的资料”这样的任务,人需要把意图转换成一系列操作。
LLM 通过大量语言材料训练,能够理解和生成语言。它可以理解使用者用日常语言表达的要求,识别资料之间的关联,并根据处理结果提出后续步骤。这使它有可能成为 CDE 的大脑,提供“思考动力”,让更多原先需要人员逐步组织的工作,成为系统自身的信息处理能力。
LLM 提供理解和推理的“智力”;harness 则组织资料供给、功能调用和执行反馈,帮助这种能力持续服务于具体任务。
Harness:让思考动力参与实际工作
Harness 原意为马具。如果把 LLM 比作提供动力的马,harness 就如同一套驾驭体系,使动力能够服务于具体工作。
以整理资料为例,LLM 提出了整理建议,并不意味着工作已经完成。系统还需要取得资料、执行修改、检查结果,并决定下一步如何处理。Harness 就是组织和支撑 LLM 与其他模块协作完成这些工作的运行机制。
放到 AI-based CDE 中,harness 同时发挥三种作用:
- 支撑:提供完成任务所需的资料、规则和软件功能,例如读取文档、查询版本。
- 协调:组织 LLM 与检索、文档管理、检查等模块协作,保存任务进度,并将执行结果反馈给 LLM。
- 约束:让操作遵守权限和流程,使成果接受检查。例如,能够读取一份文件,并不意味着有权修改或发布它。
这里可供 LLM 调用的软件功能,通常称为“工具”(tool)。以编程智能体产品 Codex 为例,其内部的 harness 组织 LLM 读取文件、使用工具、保留任务进度,并在配置的权限范围内推进工作。[2]
智能体(agent)指能够围绕任务采取行动的 AI 系统;harness 是支撑其运行的机制。两者不能混称。
图 1 表达了这种协作关系。LLM 和 harness 都参与 CDE 自身的工作,既有信息管理功能为 AI 提供依据和执行条件,AI 的能力也由此得以发挥。
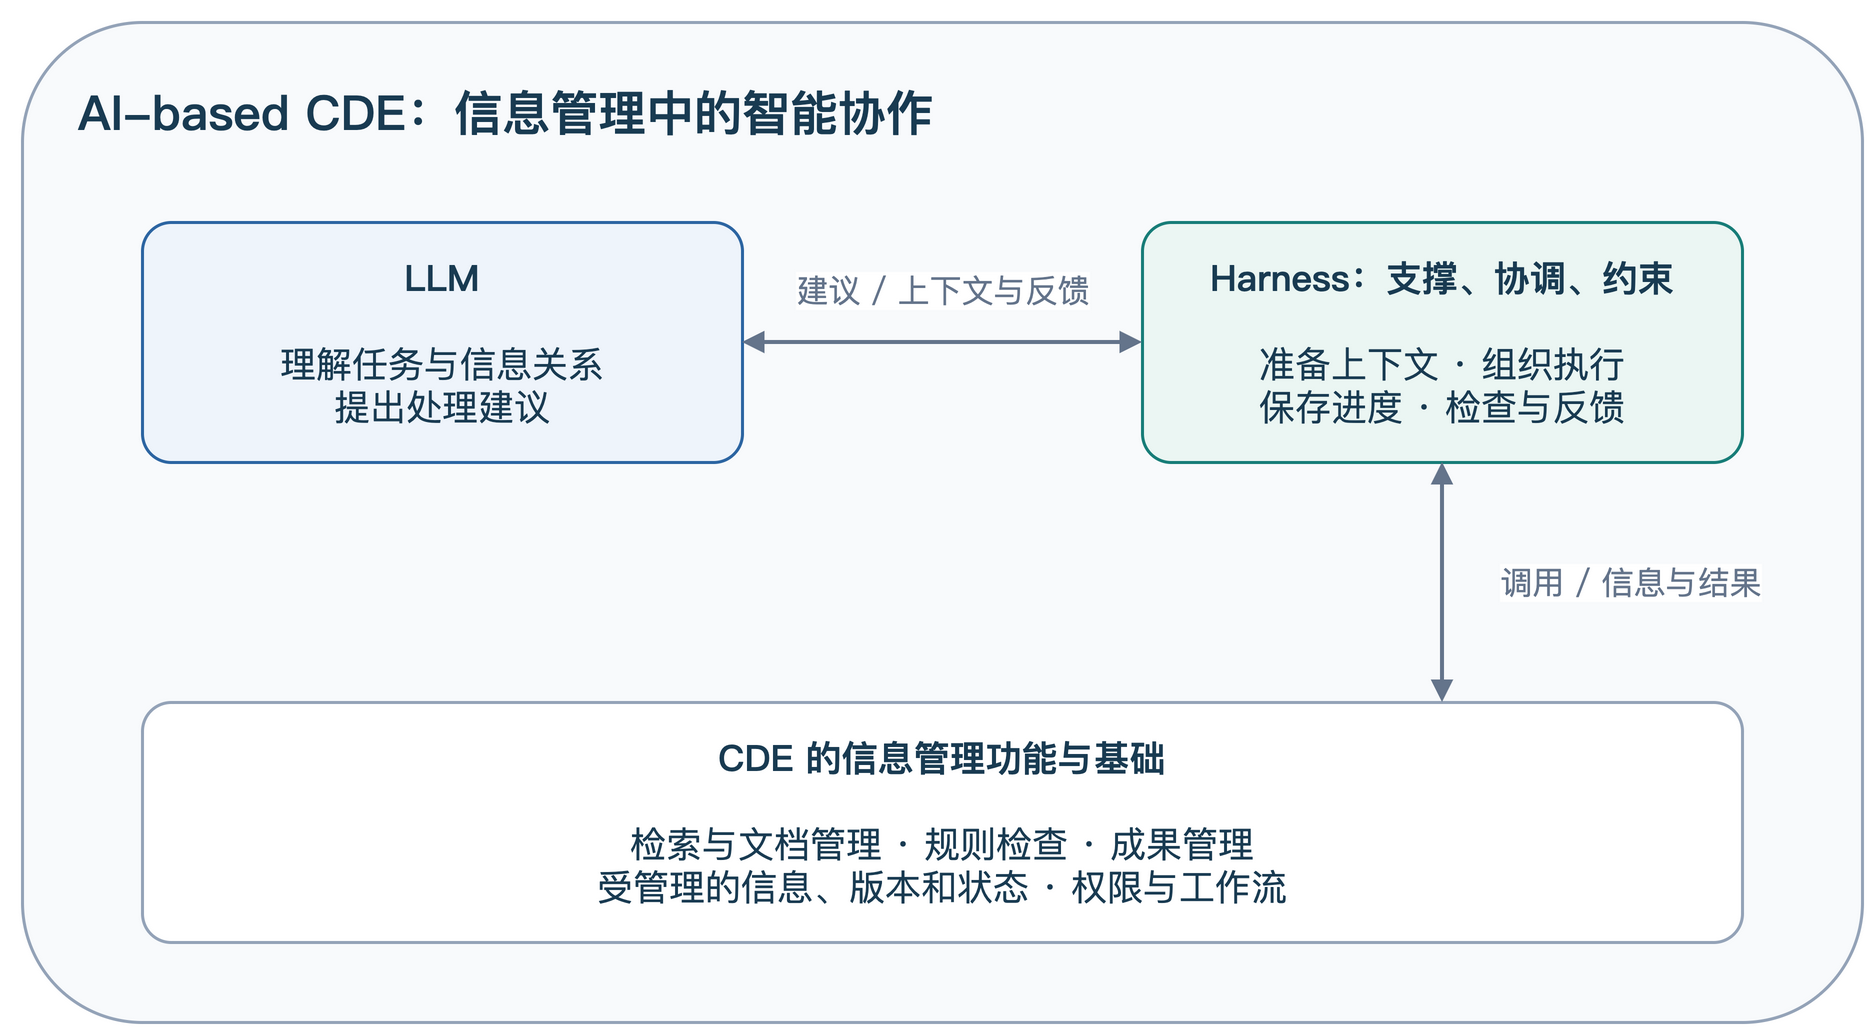
图 1 Harness 支撑 CDE 内部的智能协作
来源:本文原创。
信息检索:找到资料,还要判断能否使用
CDE 借助内部 LLM 查找某堵墙的耐火性能信息时,LLM 可以理解问题、识别相关对象;CDE 的版本和状态记录则有助于判断找到的资料是否适用于当前工作。用于方案讨论和用于施工的依据,可能并不相同。
“上下文”(context)就是 LLM 处理当前任务所依据的信息,包括使用者的问题、相关资料、适用规则和此前的处理结果。“上下文工程”(context engineering)关注如何选择、组织和持续更新这些信息。[3] 在上述例子中,墙的编号、所处项目阶段、图纸版本和获准用途,都是有助于判断的信息。
Harness 可以持续组织上下文的补充与核对,把 LLM 识别的信息需求与 CDE 的检索、版本核对等功能衔接起来。例如,发现两份资料记载不一致时,继续核对版本和用途;某个来源无法访问时,保留并说明这一缺口。CDE 因而有望更快找到更合适的资料,并能够给出判断依据。
信息整理:让多个功能接续完成任务
设想 CDE 整理一批待移交资料:内置 AI 理解分类要求,文档模块提供清单和版本,检查程序核对缺项,AI 再解释异常、提出修正建议。Harness 组织这些环节,并保留“哪些已处理、哪些待核对、应遵循哪些规则”等任务信息,使工作能够根据反馈继续开展,见图 2。
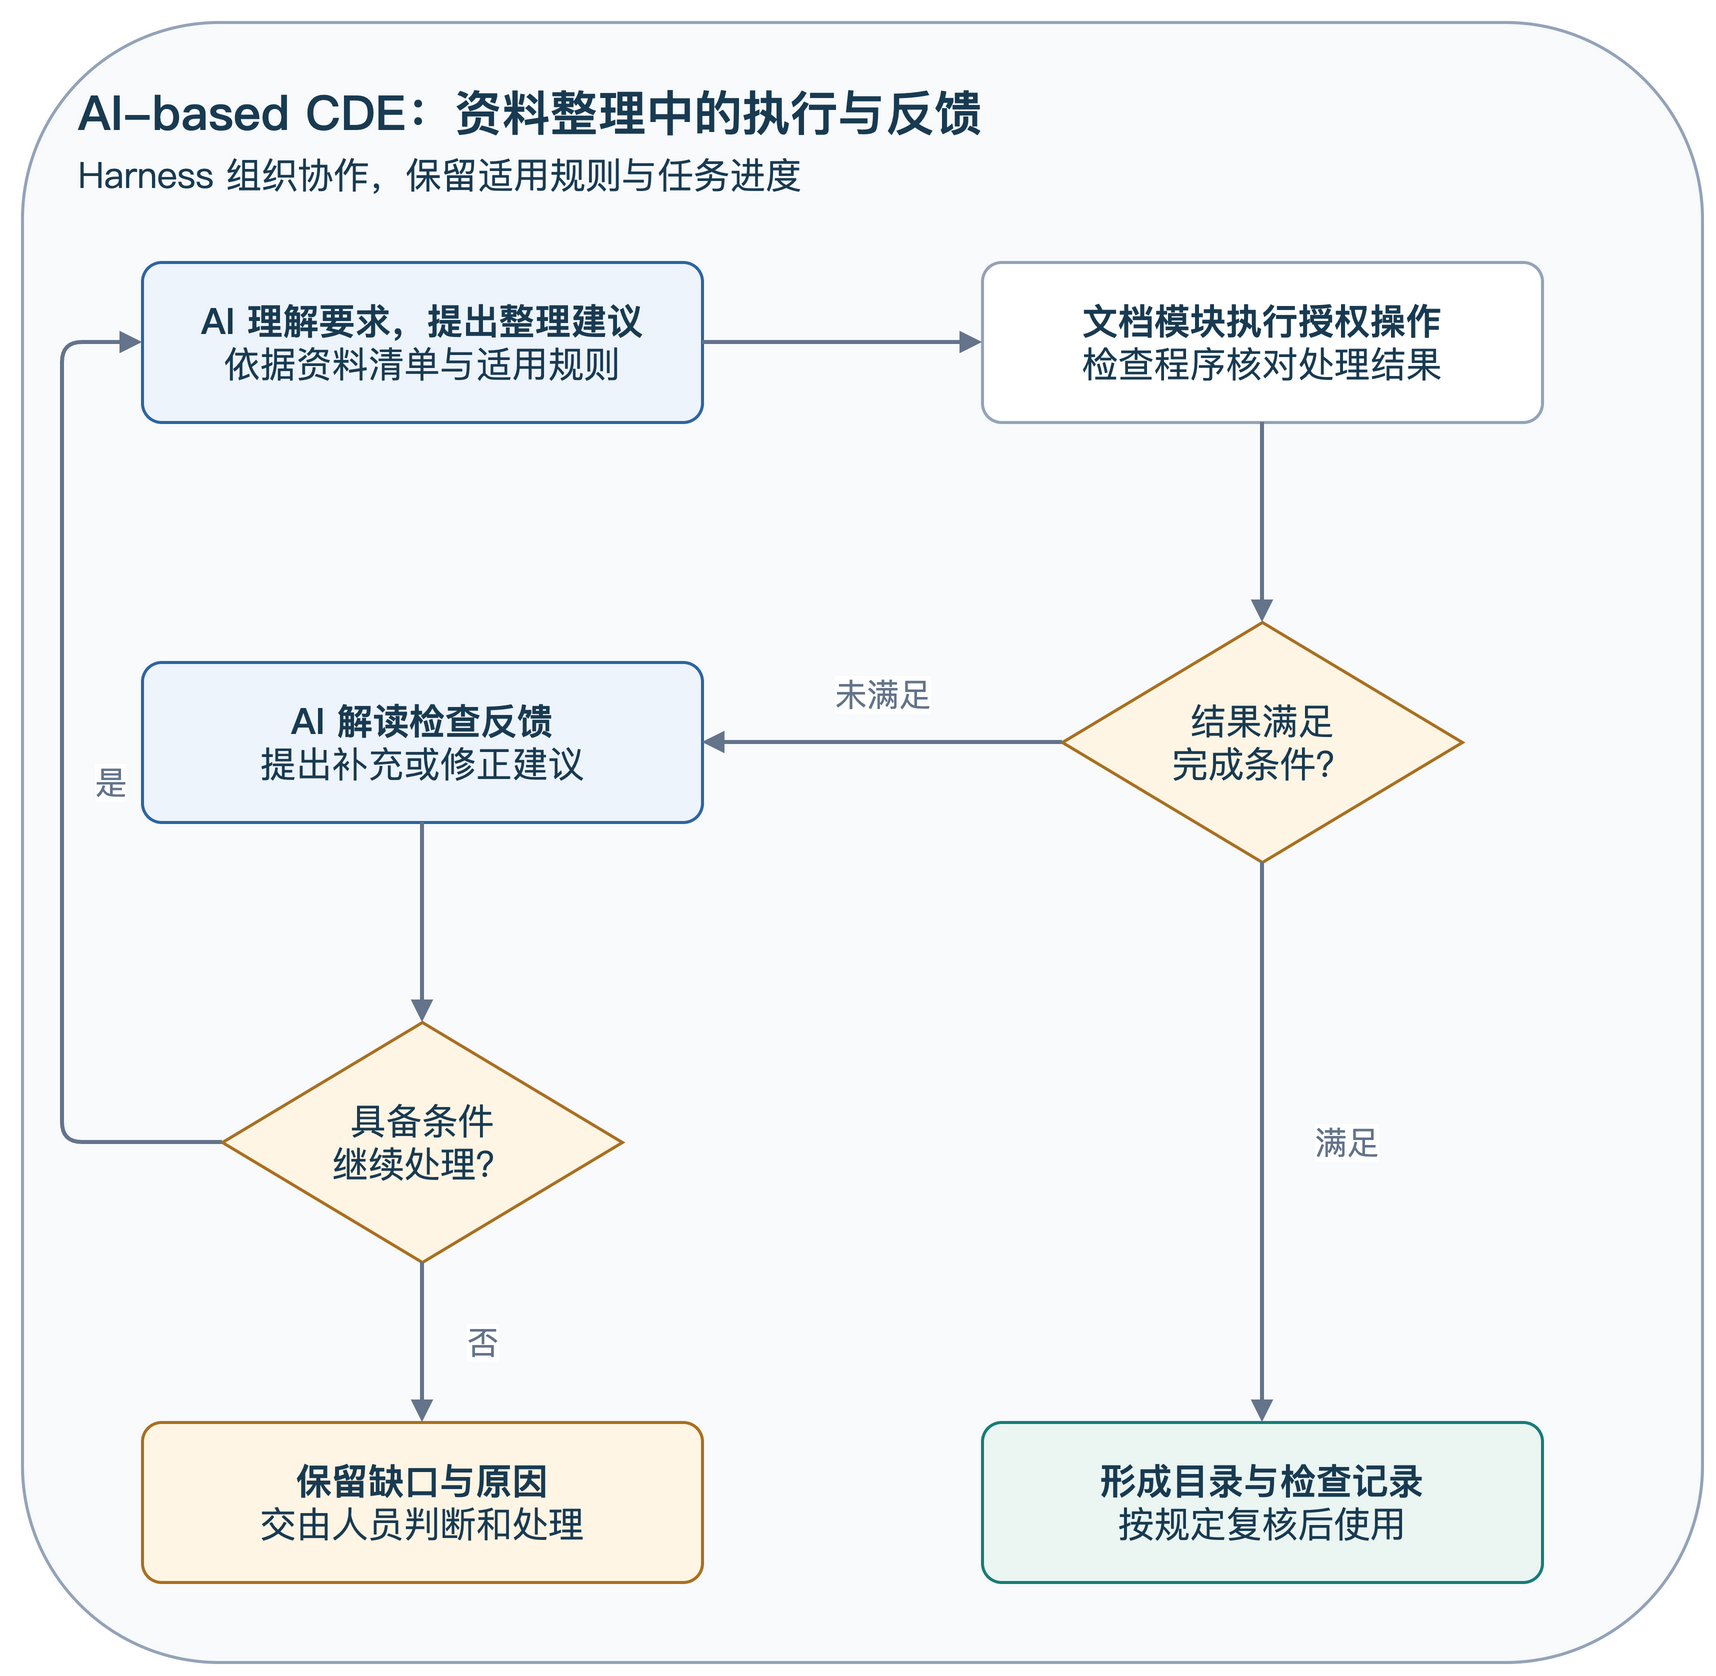
图 2 资料整理中的执行与反馈
来源:本文原创。
模块间可通过应用程序接口(Application Programming Interface,API)协作。接口约定如何请求一个软件功能、需要提供什么信息,以及返回什么结果。例如,读取文档时要指明哪份文档,执行功能会返回内容或无法读取的原因。
推动建筑业信息交换标准的 buildingSMART 所提出的 openCDE Documents API(openCDE 文档接口),已为文档上传下载和版本信息获取提供基础。[4] API 提供调用功能的约定;harness 组织何时调用、如何利用结果、遇到问题如何继续处理。实际执行操作的模块还要核查权限和资料状态,例如阻止未经授权的修改。
这一结合的收益,是减少人员在多个功能间反复操作、传递结果和接续任务的负担,使注意力更多集中于歧义和异常。它增强了 CDE 原有功能的协作能力。
信息检查:让智能分析有据可验
LLM 可以辅助理解要求、解释疑点。对于能够明确表达的检查条件,例如“某个属性是否填写”“数值是否在约定范围内”,专门程序可以逐项核对。Harness 是检查的组织者,并把发现的问题交回后续处理环节。
buildingSMART 的两项标准可以帮助理解这种检查:
- IFC(Industry Foundation Classes):用于不同软件间交换建筑信息模型的开放标准。它使墙、门等对象及其属性能够按照共同的数据定义表达。
- 信息交付规范(Information Delivery Specification,IDS):将“要交付什么信息”表达为计算机可读取的规则,供检查软件核对 IFC 模型。例如,要求某类门填写指定属性,并检查有无遗漏。
两者配合时,IFC 模型承载交付的数据,IDS 表达检查所依据的信息要求,见图 3。IDS 1.0 主要针对属性、分类等非几何信息,不覆盖构件碰撞、疏散距离等几何分析。[5]
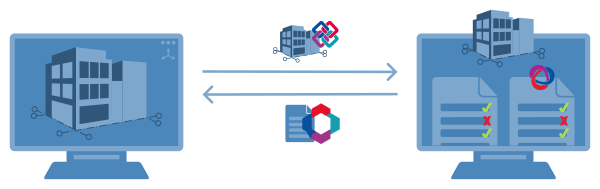
图 3 IDS 与 IFC 配合进行信息检查
来源:buildingSMART IDS 用户手册。© buildingSMART International Ltd.,按 CC BY-ND 4.0(署名、禁止演绎)许可原样使用。
在 CDE 内部,harness 可以把检查组织成一个有反馈的过程:
- 检查前:保留当前任务适用的要求、检查范围和完成条件,作为后续处理的依据。
- 检查时:调用相应检查程序,记录实际结果,并把未通过的项目反馈给 LLM,支持其分析原因、提出补充或修正建议。
- 检查后:对照检查清单核对有无遗漏。必要检查尚未执行时,保留任务未完成状态;资料经授权补充或修订后,再组织复查。
这样,harness 就把检查结果与任务能否结束、下一步如何处理联系起来,使 CDE 能够依据实际检查记录判断完成情况,减少 LLM 过早宣称“已完成”的问题。LLM 形成的说明也应区分未通过、未检查和无法判断的事项,供人员继续处理。
这些机制仍需恰当的检查规则。规则即使格式正确,也可能没有准确表达原始要求;属性检查合格也不能证明整个设计符合消防要求。涉及专业正确性的结论,仍需相应人员作出判断。
成果溯源:让每份成果有据可查
Harness 在 CDE 内部组织 LLM 与其他模块协作时,可以同步记录所用资料的版本、采用的规则、调用的功能及其实际结果,并把这些记录与生成的说明或报告关联。这样,成果形成的过程就能留下可核对的记录。
这为成果溯源(provenance)提供了依据。溯源关注资料的来源及形成经过:它依据了什么,经过哪些处理,与哪些人员或软件有关?当报告被再次引用时,使用者可以查到这些记录,判断结论是否仍然适用。
万维网联盟(World Wide Web Consortium,W3C)的 PROV-O(PROV Ontology,PROV 溯源本体)提供了一套通用表达方法。“本体”(ontology)可以理解为供软件共同使用的概念及关系定义,使不同系统能够按相同含义记录和理解这些信息。其核心包括:
- 实体(Entity):被使用或产生的资料等对象,如某一版建筑信息模型或检查报告。
- 活动(Activity):处理过程,如一次检查或复核。
- 行动主体(Agent):对活动或成果具有某种责任的人员、组织或软件,含义比 AI 智能体更广。
例如,一次检查使用某一版建筑信息模型,由某个检查软件执行,并生成报告。将建筑信息模型、检查过程、软件和报告联系起来,就能从报告反查依据。[6] 图 4 展示了基本关系。
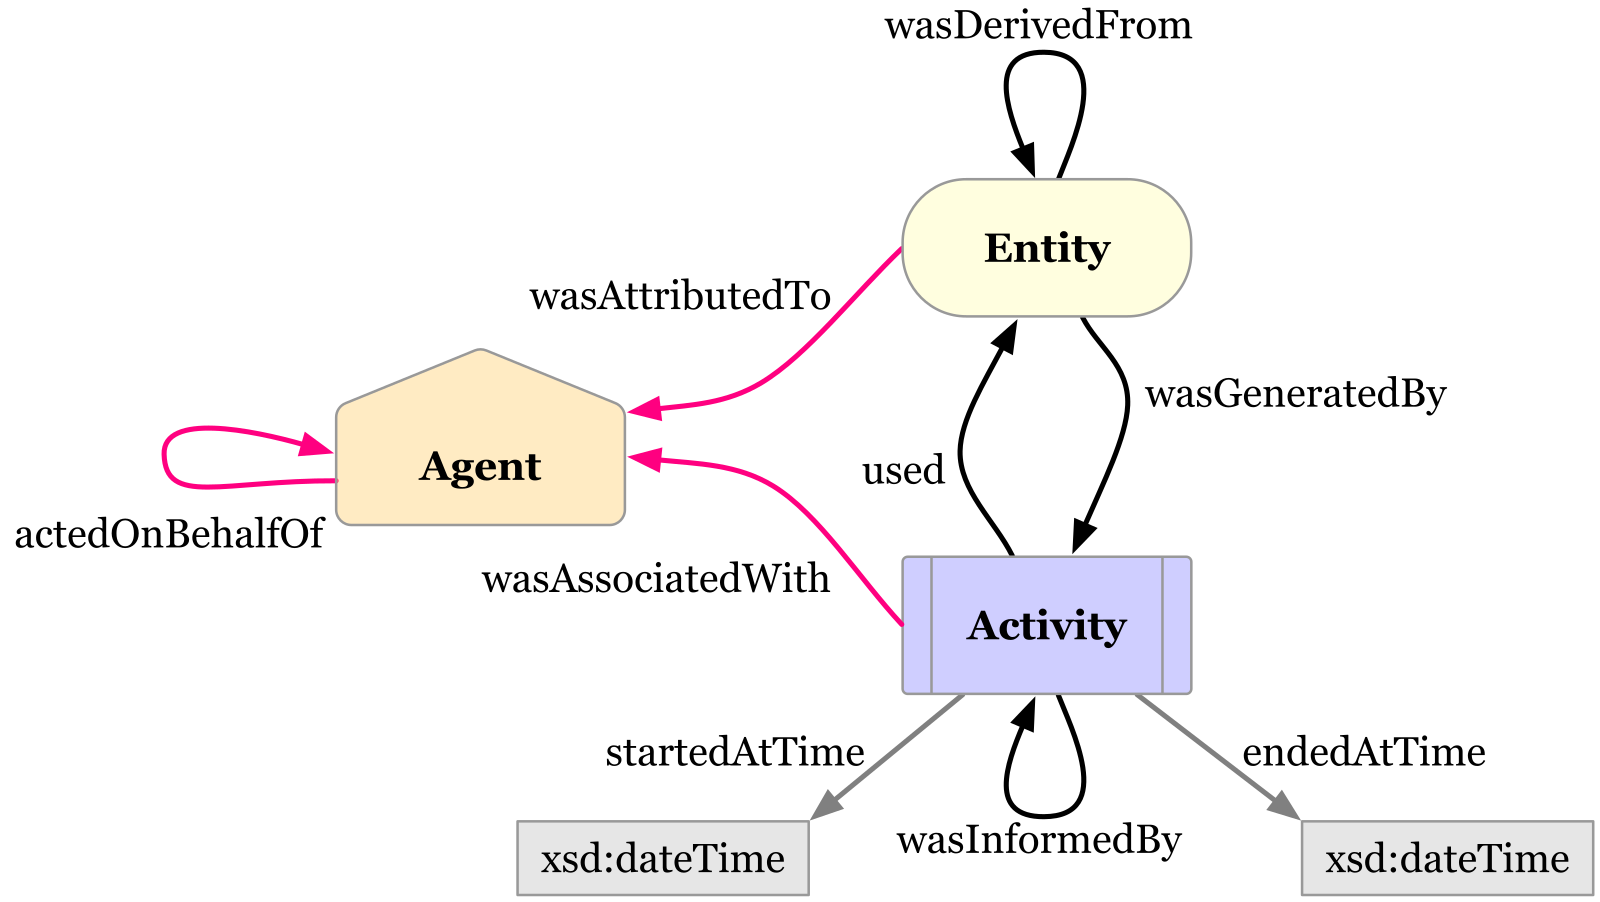
图 4 PROV-O 的基础概念与关系
图注:图中 Entity、Activity、Agent 对应上述三类对象;used 表示使用,wasGeneratedBy 表示由活动生成,wasAssociatedWith 表示与主体关联。回环箭头表示同类对象之间的关系,xsd:dateTime 表示日期与时间。
来源:W3C《PROV-O》图 1,W3C 推荐标准,2013 年 4 月 30 日。该图为资料性说明,图形与文字保持原貌。Copyright © 2011–2013 W3C® (MIT, ERCIM, Keio, Beihang), All Rights Reserved;按 W3C 文档许可使用。
建筑信息模型或文件更新后,CDE 可以沿已记录的关系查找可能受影响的报告,并通过 harness 组织重新核验或提示人员复核。溯源记录由此既能帮助查证过去,也能支持后续工作。结论是否正确、成果能否发布,仍取决于相应检查和授权。
结语
CDE 已经建立了信息管理的流程和技术基础,LLM 为其中较多依赖人员理解、判断和组织的工作带来了新的可能。Harness 将资料供给、功能调用、执行反馈和运行约束组织起来,使 AI 与 CDE 其他模块能够围绕任务持续协作。信息检索、资料整理、检查和成果溯源,都可能由此得到增强。
Harness 对 CDE 构建的启示,在于 LLM 的智能能力与 CDE 的信息治理能力可以相互支撑。
信息治理所关注的,是资料由谁提供、谁能使用、用于什么工作,以及如何检查和追溯。这种结合有望减少重复操作,提高信息的适用性和处理过程的可靠性。能力的增强仍立足于 CDE 的信息管理职责,收益也取决于资料是否可靠、规则是否恰当,以及实际任务表现。
未来值得期待的 AI-based CDE,能够更好地理解使用者需要什么,借助已有功能持续处理信息,并清楚呈现成果及其局限。当资料发生变化时,这种协作还可能支持对相关结论的持续复核,为工程人员提供更及时、更有依据的信息支持。
参考文献
- UK BIM Framework. Guidance Part C: Facilitating the common data environment (workflow and technical solutions)[CDE 工作流与技术方案实施指南]. 第 1 版,2020 年 9 月,第 1、2、5、6 节。原文
- Bonamy N, Choi D. Codex as a platform: build on the open agent harness[Codex 作为平台:基于开放的智能体运行机制构建应用]. OpenAI Developers,2026 年 8 月 19 日。原文
- Mei L, Yao J, Ge Y, et al. A Survey of Context Engineering for Large Language Models[大语言模型上下文工程综述]. arXiv 预印本,arXiv:2507.13334v2,2025 年 7 月 21 日,第 3.1 节。原文
- buildingSMART. Documents API: Part of the openCDE portfolio[openCDE 文档接口技术说明]. 1.0 版技术文档,第 2.1、2.2、3.4 节,访问日期:2026 年 9 月 8 日。原文
- buildingSMART International. Information Delivery Specification (IDS)[信息交付规范:介绍与常见问题]. 官方技术介绍,访问日期:2026 年 9 月 8 日。原文
- W3C. PROV-O: The PROV Ontology[PROV 溯源本体]. W3C 推荐标准,2013 年 4 月 30 日,第 3.1、3.2 节。原文